スケーリング則とは何か――AIはなぜ「大きくすると賢くなる」のかをやさしく理解する
前回は、「小規模言語モデルとは何か」について説明しました。小規模言語モデルとは、大規模言語モデルよりも小さく、少ない計算量で動かしやすいAIです。
そこで、少し不思議に思った人もいるかもしれません。AIには小型化する流れがある一方で、これまでAI企業は、巨大なコンピューターを使って、より大きなAIモデルを作ってきました。では、なぜAIを大きくするのでしょうか。単純に「大きい方が強そうだから」ではありません。
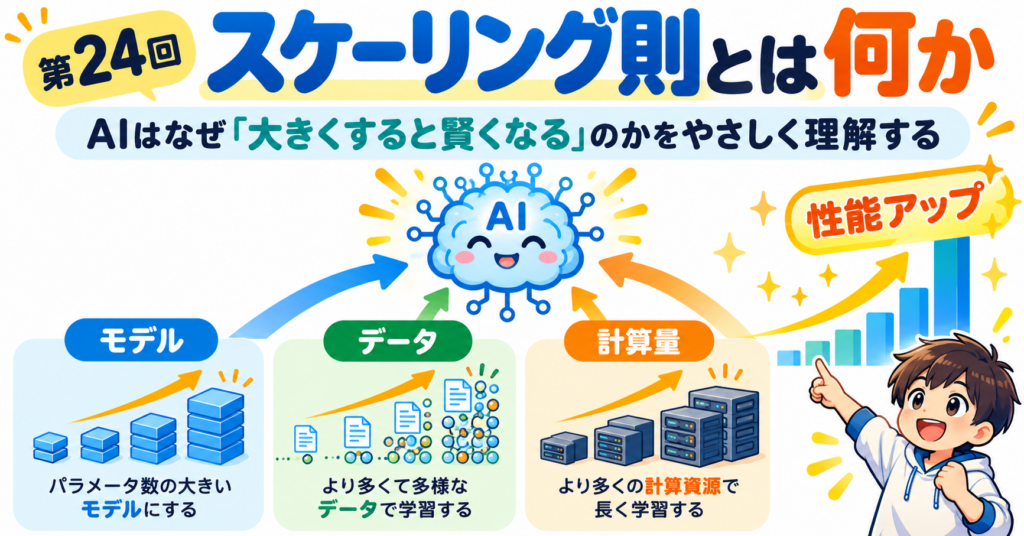
AIの研究では、モデルの大きさ、学習するデータの量、学習に使う計算量などを増やすと、AIの性能もある程度予測できる形で向上するという傾向が見つかっています。
これをスケーリング則と呼びます。英語では Scaling Laws といいます。一言でいうと、スケーリング則とは、AIに使うモデル・データ・計算量を増やすと、性能がどのように変化するかを表す経験的な法則です。
- 1 そもそも「スケーリング」とは何か
- 2 スケーリング則は「勉強量を増やすと成績が上がる」に少し似ている
- 3 AIを大きくする3つの方法
- 4 モデルを大きくすると何が起こるのか
- 5 データも増やす必要がある
- 6 計算量も必要になる
- 7 なぜ「法則」と呼ばれるのか
- 8 だからAI企業は巨大な計算設備を作ってきた
- 9 ただし「大きくすれば無限に賢くなる」わけではない
- 10 「大きいモデル」だけ作ってもだめ
- 11 データの「量」だけでなく「質」も重要
- 12 小規模言語モデルとは矛盾しないのか
- 13 AIの「効率」も進歩している
- 14 ここまでは「学習するとき」のスケーリング
- 15 推論時スケーリングとは何か
- 16 テストで「すぐ答える」か「じっくり考える」か
- 17 推論モデルとの関係
- 18 小さいAIを長く考えさせるという選択肢もある
- 19 簡単な質問までじっくり考える必要はない
- 20 スケーリングにはお金と電力が必要
- 21 これからは「どれだけ大きいか」だけではない
- 22 スケーリング則を理解するとAI企業の動きが見えてくる
- 23 スケーリング則には限界があるのか
- 24 まとめ
そもそも「スケーリング」とは何か
スケーリングとは、規模を大きくしたり小さくしたりすることです。
AIの場合、主に次のようなものを大きくすることを指します。
- AIモデルの大きさ
- 学習に使うデータの量
- 学習に使う計算量
たとえば、より大きなニューラルネットワークを作り、より大量の文章を読み込ませ、より多くのコンピューターを使って学習させます。すると、多くの場合、AIの性能が向上します。しかも、「なんとなく良くなる」のではなく、一定の範囲ではかなり規則的に性能が変化することがわかってきました。その規則性が、スケーリング則です。
スケーリング則は「勉強量を増やすと成績が上がる」に少し似ている
学校の勉強で考えてみましょう。ほとんど勉強していない人が、毎日少し勉強するようになれば、テストの成績はかなり上がるかもしれません。さらに勉強時間を増やし、問題集をたくさん解けば、もっと成績が上がる可能性があります。
AIにも、少し似たことがあります。より大きなモデルにして、より多くのデータを学び、より多くの計算を行わせると、AIはより多くのパターンを学べるようになります。ただし、人間の勉強と同じように、単純に量を増やせば無限に良くなるわけではありません。その点は後で説明します。
AIを大きくする3つの方法
AIのスケーリングを考えるとき、特に重要なのが「モデル」「データ」「計算量」の3つです。
| 増やすもの | 意味 | たとえ |
|---|---|---|
| モデルの大きさ | パラメータなどを増やし、より大きなニューラルネットワークにする | より大きな頭脳を用意する |
| データ量 | より多くの文章や情報を学習させる | より多くの本や問題集を読む |
| 計算量 | 学習により多くのコンピューターや時間を使う | より長い時間をかけて練習する |
この3つは、お互いに関係しています。巨大なモデルを作っても、学習データが少なすぎれば十分に力を発揮できません。大量のデータがあっても、計算能力が足りなければ十分に学習できません。つまり、どれか一つだけを増やせばよいわけではありません。
モデルを大きくすると何が起こるのか
第7回のニューラルネットワークで、「重み」について説明しました。AIのニューラルネットワークには、学習によって調整される大量の数値があります。これらを含む、学習によって決まる値をパラメータと呼びます。モデルを大きくすると、一般に扱えるパラメータの数も増えます。すると、より複雑なパターンを表現できるようになります。
たとえば、単純なAIなら、文章の中の簡単な言葉のつながりしか学べないかもしれません。より大きなモデルなら、長い文脈、複雑な言い回し、専門的な文章など、より多くのパターンを扱える可能性があります。これが、AIの巨大化が進んだ理由の一つです。
データも増やす必要がある
しかし、大きなモデルを作るだけでは十分ではありません。巨大なニューラルネットワークを作っても、学習させるデータが少なければ、その能力を十分に使えません。
たとえば、100冊の本を覚えられる力を持った生徒に、1冊しか本を渡さなければ、その力は余ってしまいます。逆に、大量の本を渡しても、学習する能力や時間が足りなければ十分に身につきません。AIでも、モデルの規模とデータ量のバランスが重要です。
計算量も必要になる
大きなモデルに大量のデータを与えると、それだけ計算も増えます。AIの学習では、データを入力し、予測を行い、間違いを確認し、モデル内部の重みを少しずつ調整します。これを膨大な回数繰り返します。そのため、大規模なAIを作るには、大量のGPUなどを使った巨大な計算設備が必要になります。
つまり、AIをスケールさせるというのは、モデルだけを大きくすることではありません。
モデル、データ、計算能力をまとめて大きくしていくということです。
なぜ「法則」と呼ばれるのか
スケーリング則が興味深いのは、規模を大きくしたときの性能向上に、ある程度規則的な傾向が見られることです。たとえば、モデルや計算量を何倍かに増やすと、AIの予測の誤差が一定の傾向で小さくなっていくことが観測されました。もちろん、すべてのAI、すべての能力でまったく同じになるわけではありません。しかし、「もっと大きくしたら性能はどうなりそうか」をある程度予測できることは、AI開発に大きな意味があります。
新しい巨大モデルを作るには、大きな費用がかかります。完成するまで結果がまったくわからないのでは、開発する企業にとって大きな賭けになります。スケーリング則がわかれば、「このくらい計算量を増やせば、この程度の性能向上が期待できそうだ」という見通しを立てやすくなります。
だからAI企業は巨大な計算設備を作ってきた
近年、AI企業が大量のGPUや巨大なデータセンターへ投資しているのも、スケーリング則と関係があります。計算量を増やすことで性能向上が期待できるなら、より多くの計算資源を用意することには意味があります。モデルを大型化し、大量のデータで学習させることで、AIの性能は大きく向上してきました。この流れが、大規模言語モデル、つまりLLMの「Large」という言葉にもつながっています。
ただし「大きくすれば無限に賢くなる」わけではない
ここは非常に重要です。スケーリング則は、「AIを大きくすれば必ず何でもできるようになる」という法則ではありません。規模を増やせば性能が上がる傾向があっても、さまざまな問題があります。
- 性能向上がだんだん小さくなることがある
- 必要な計算量が非常に大きくなる
- 電力消費が増える
- 大量の高品質データを集める必要がある
- 学習費用が増える
- ハルシネーションなどが完全になくなるわけではない
たとえば、モデルを2倍にしたからといって、必ず性能が2倍になるわけではありません。より大きな改善を得るために、さらに大量の計算が必要になることがあります。
「大きいモデル」だけ作ってもだめ
AI開発では、モデルの大きさとデータ量のバランスも重要だとわかってきました。巨大なモデルを作っても、十分なデータで学習させなければ、その力を使い切れません。逆に、小さすぎるモデルに大量のデータを与えても、学習できる能力に限界があります。つまり、限られた計算予算の中で、
- モデルをどれくらい大きくするか
- どれくらいのデータを学習させるか
- どれくらい学習を続けるか
を適切に配分する必要があります。
AI開発では、「最大のモデルを作る」だけではなく、「同じ計算量で最も性能が高くなる組み合わせを探す」ことも重要なのです。
データの「量」だけでなく「質」も重要
スケーリングというと、とにかくデータを大量に集めればよいように思えます。しかし、データの質も重要です。違った文章、重複した情報、意味のない文章などを大量に増やしても、AIが必ず賢くなるわけではありません。最近のAI開発では、単純にデータ量を増やすだけでなく、良質なデータを選ぶことも重視されています。
また、人間が作ったデータだけでなく、AIが作った合成データを学習に利用する方法もあります。つまり、スケーリングは「何でも大量に入れる」という意味ではありません。
小規模言語モデルとは矛盾しないのか
前回、小規模言語モデルについて説明しました。「大きくすると性能が上がる」のなら、なぜ小さなAIを作るのでしょうか。これは矛盾しているように見えます。しかし、実際には別の問題です。
スケーリング則は、規模を増やしたときに性能がどう変化するかを扱います。一方、小規模言語モデルでは、「必要な仕事をするために、どこまで小さくできるか」が重要です。
たとえば、高度な数学研究まで行うAIと、メールを3種類に分類するAIでは、必要な能力が違います。メール分類だけなら、巨大なモデルを使う必要がないかもしれません。
つまり、
- 最高性能を目指して大きくする
- 十分な性能を保ちながら小さくする
という両方の研究が同時に進んでいます。
AIの「効率」も進歩している
AIの進歩は、モデルを巨大化することだけではありません。同じ大きさでも、より良い学習方法やデータを使うことで性能を高めることができます。
また、同程度の性能を、より小さなモデルで実現できるようになることもあります。これはコンピューターの歴史と少し似ています。
昔は巨大なコンピューターでしかできなかった処理が、技術の進歩によって小さなパソコンやスマートフォンでもできるようになりました。AIでも、単純な巨大化と同時に、「より効率よく賢くする」という方向が進んでいます。
ここまでは「学習するとき」のスケーリング
ここまで説明してきたのは、主にAIを作るとき、つまり学習時のスケーリングです。
モデルを大きくする。
データを増やす。
学習に使う計算量を増やす。
これらは、AIを完成させる前の段階で行われます。
しかし最近では、もう一つのスケーリングが重要になっています。
それが、推論時のスケーリングです。
推論時スケーリングとは何か
第12回で説明したように、推論とは、学習済みのAIが質問に対して答えを出す処理です。この「答えるとき」に、より多くの計算を使って性能を高めようという考え方があります。これを推論時スケーリング、あるいはTest-Time Compute Scalingなどと呼びます。簡単に言うと、難しい問題には、AIにも少し長く考えさせるという考え方です。
テストで「すぐ答える」か「じっくり考える」か
人間のテストで考えてみましょう。「日本の首都はどこですか」という問題なら、ほとんど考える必要はありません。「東京」とすぐ答えられます。しかし、複雑な数学問題ならどうでしょうか。条件を書き出し、式を作り、計算し、答えを確認する必要があります。同じ人でも、1秒で答える場合と10分かけて考える場合では、正解できる問題が違います。
AIでも似た考え方ができます。簡単な質問には少ない計算で答え、難しい質問にはより多くの計算を使います。これが推論時スケーリングの基本的なイメージです。
推論モデルとの関係
第13回で説明した推論モデルは、この流れと深く関係しています。推論モデルは、複雑な問題を段階的に処理することを得意としています。難しい問題では、より長く処理したり、複数の考え方を試したり、答えを確認したりすることで性能を高める方法があります。
つまり、AIの性能を上げる方法が、
- 学習時に巨大なAIを作る
- 回答時により多く考えさせる
という二つの方向へ広がってきたのです。
| 方法 | いつ計算を増やすか | 何をするか |
|---|---|---|
| 学習時スケーリング | AIを作るとき | モデル・データ・学習計算量を増やす |
| 推論時スケーリング | AIが答えるとき | 問題に応じて考えるための計算量を増やす |
小さいAIを長く考えさせるという選択肢もある
推論時スケーリングが面白いのは、「モデルそのものを大きくする以外の方法」が生まれることです。非常に大きなAIを一度だけ動かす。あるいは、もう少し小さなAIに複数回考えさせる。問題によっては、後者が有効な場合もあります。もちろん、どんな問題でも長く考えれば必ず正解するわけではありません。間違った考えを長く続ける可能性もあります。そのため、AI自身の答えをチェックする仕組みや、複数の答えからよいものを選ぶ方法なども研究されています。
簡単な質問までじっくり考える必要はない
推論時に計算を増やせば性能が上がるとしても、すべての質問に大量の計算を使うのは効率的ではありません。
たとえば、「こんにちは」と言われたAIが、何十秒も考える必要はありません。文章の言い換えや簡単な要約にも、高度な推論は必要ないことがあります。一方、複雑な数学、プログラミング、長期計画などでは、より多くの計算が役立つ場合があります。つまり、これからは、問題の難しさに応じて使う計算量を変えることも重要になります。
スケーリングにはお金と電力が必要
スケーリングには大きな問題もあります。計算量を増やせば、それだけコンピューターが必要になります。コンピューターを動かすには電力が必要です。巨大なAIモデルの学習には、大規模なデータセンターも必要になります。推論時スケーリングでも、AIに長く考えさせれば、その分計算量が増えます。
つまり、AIの性能向上には、
- 性能
- 速度
- 費用
- 電力
のバランスを考える必要があります。
これからは「どれだけ大きいか」だけではない
初期の大規模言語モデル競争では、モデルの大きさが非常に注目されました。しかし、現在のAIを見ると、それだけでは説明できなくなっています。
AIの性能には、さまざまな要素が関係します。
- モデルの大きさ
- 学習データの量
- データの質
- 学習方法
- モデル構造
- ファインチューニング
- 推論時に使う計算量
- ツールや検索との組み合わせ
つまり、「パラメータ数が一番多いAIが一番優秀」と単純に考えることはできません。
スケーリング則を理解するとAI企業の動きが見えてくる
スケーリング則を知ると、AI業界のニュースも理解しやすくなります。
なぜAI企業が大量のGPUを購入するのか。
なぜ巨大なデータセンターを建設するのか。
なぜ大量の学習データが必要なのか。
なぜ一方では小型モデルの研究も進んでいるのか。
なぜ推論モデルでは、回答に使う計算量が話題になるのか。
これらは、すべて「AIの能力をどうスケールさせるか」という問題につながっています。AIの進歩は、単純にモデルを大きくする競争から、限られた計算資源をどこで、どのように使えば最も賢くなるのかを考える競争へ広がっています。
スケーリング則には限界があるのか
「このまま計算量を増やし続ければ、AIはどこまでも賢くなるのか」という疑問があります。現時点では、簡単な答えはありません。
従来の方法をさらに大きくすることで、どこまで性能が上がるのか。
高品質なデータを十分に確保できるのか。
必要な電力や計算設備を用意できるのか。
推論時の計算を増やすことで、どこまで能力を伸ばせるのか。
さまざまな研究が続いています。
そのため、「スケーリング則が終わった」「大きくすれば必ずAGIになる」といった極端な見方のどちらも、慎重に考える必要があります。スケーリングは非常に強力な方法ですが、AIの進歩を決める唯一の方法ではありません。
まとめ
スケーリング則とは、AIモデルの大きさ、学習データの量、計算量などを増やしたとき、AIの性能がどのように変化するかを表す経験的な法則です。
AI研究では、これらを増やすと、一定の範囲で性能が規則的に向上することが確認されてきました。この発見が、大規模言語モデルの巨大化や、大量のGPUを使ったAI開発を後押ししてきました。ただし、モデルだけを大きくすればよいわけではありません。モデルの規模、データ量、計算量のバランスが重要です。また、データは量だけでなく質も重要です。そして現在では、AIを学習するときのスケーリングだけでなく、AIが質問に答えるときに計算量を増やす「推論時スケーリング」も重要になっています。つまり、AIの性能を高める方法は、「もっと巨大なモデルを作る」だけではなくなっています。
大きなモデル、小さなモデル、よりよいデータ、効率的な学習、そして必要な問題にだけ多くの計算を使う。こうしたさまざまな方法を組み合わせて、AIは進歩しています。
スケーリング則を理解すると、なぜAI企業が巨大な計算設備へ投資しているのか、なぜ一方で小規模言語モデルが注目されているのか、そしてなぜ推論モデルが急速に発展しているのかが、一つの流れとして見えてきます。
次回は、「AIの安全性とは何か」について説明します。
AIがより強力になり、外部の情報を調べ、ツールを使い、現実の作業まで行えるようになるほど、「どこまでAIに任せてよいのか」という問題が重要になります。AIの安全性とは何を守るためのものなのかを、やさしく理解していきます。